Koja je razlika između crawlinga, indeksiranja i rangiranja?
Jednostavno rečeno: Ovo su tri različita koraka: Google prvo poseti stranicu, zatim je obradi i sačuva u svojoj bazi, i tek onda odlučuje gde će je prikazati. Problem u jednom koraku ne rešava se popravkom drugog.Primer: Ako stranica uopšte nije u Google bazi, nema smisla menjati naslove — prvo treba otkriti zašto nije sačuvana.
Crawling je preuzimanje pronađenog URL-a, indeksiranje je analiza i mogući izbor dokumenta za Google indeks, a rangiranje je određivanje redosleda indeksiranih kandidata za konkretan upit. URL može biti crawl-ovan, a da ne bude indeksiran; može biti indeksiran, a da nema vidljiv prikaz za upite koje posmatrate.
Šta Crawling indexing ranking znači u praksi?
Pre crawlinga postoji otkrivanje URL-a. Google može adresu pronaći preko crawlable linka, sitemap-a ili ranijeg zapisa. Crawler zatim šalje HTTP zahtev i dobija status, zaglavlja i dokument. robots.txt (fajl koji botovima kaže koje delove sajta ne treba da obilaze) može sprečiti zahtev, server može vratiti grešku, a JavaScript sadržaj može zahtevati kasnije renderovanje. Ni jedan od tih koraka sam ne kaže da je sadržaj prihvaćen u indeks.
Tokom indeksiranja sistem analizira glavni sadržaj, naslove, jezik, slike, linkove i duplikate. Ako više URL-ova ima isti ili vrlo sličan centerpiece, mogu biti grupisani, a jedan izabran kao canonical (oznaka koja kaže pretraživaču koja je „prava“ adresa kad ista stranica postoji na više adresa). Tek iz indeksa sistemi mogu da pronađu kandidate za korisnikov upit. Rangiranje zatim uzima u obzir relevantnost, korisnost, kvalitet i kontekst pretrage. Zbog toga izraz „stranica ne rangira” mora biti razložen na proverljive faze.
Kako dokument prolazi kroz sistem pretrage?
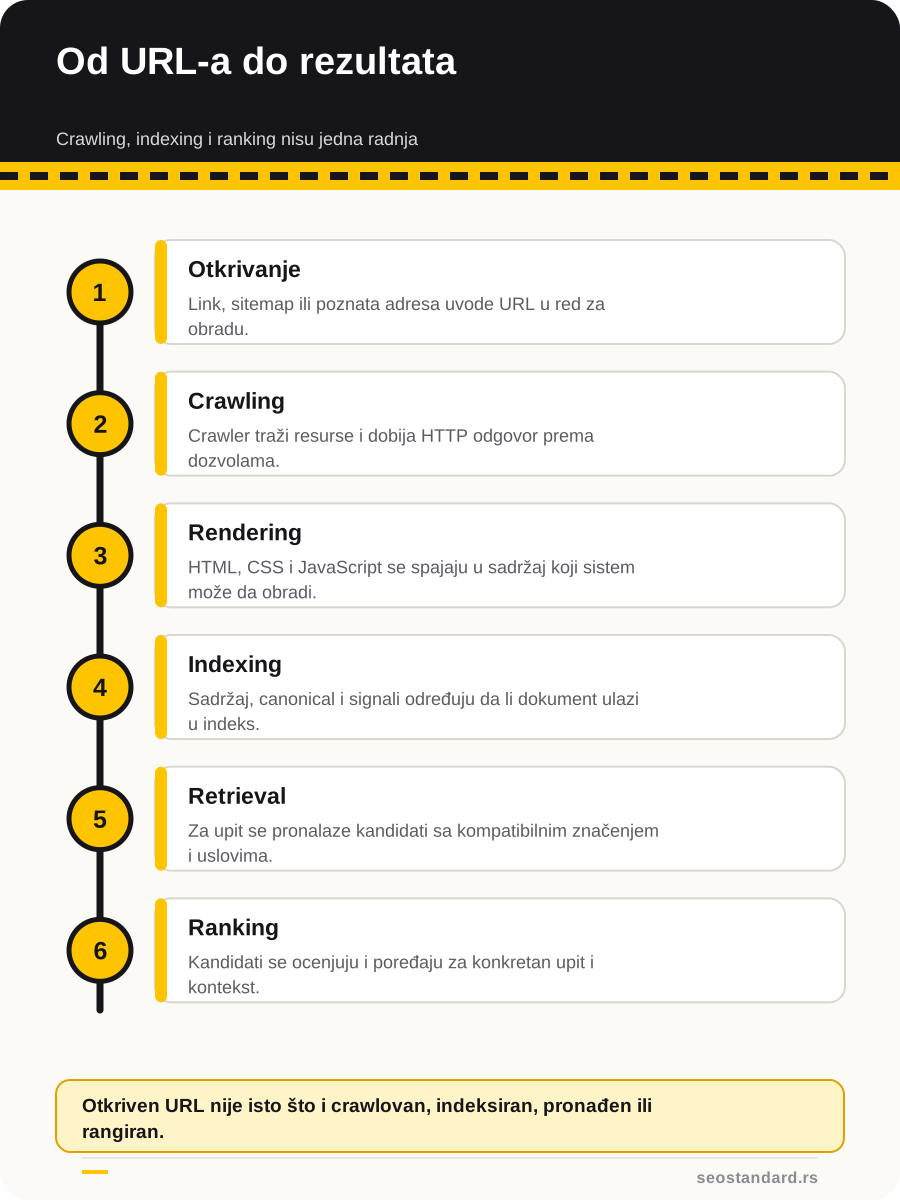
Crawling indexing ranking: koje elemente treba razlikovati?
| Element | Značenje ili atribut | Dokaz ili funkcija |
|---|---|---|
| Otkrivanje | Da li sistem zna da URL postoji | Interni link, sitemap (spisak stranica koje sajt prijavljuje pretraživaču) i ranije poznata adresa |
| Crawling | Da li je crawler zatražio i preuzeo URL | Server log, status kod i robots pravila |
| Renderovanje | Da li je izvršen potreban JavaScript i izdvojen sadržaj | Renderovani (kada pretraživač izvrši kod stranice da vidi ono što vidi korisnik) HTML i URL Inspection |
| Indeksiranje | Da li je sadržaj obrađen i izabran URL | Page Indexing i Google-selected canonical |
| Rangiranje | Za koje upite i kontekste se dokument prikazuje | GSC upiti, stranice, zemlja, uređaj i datum |
Oznake uz kriterijume (Zahtev, Potvrđena praksa, Urednička preporuka, Upozorenje, Hipoteza) pokazuju koliko je tvrdnja dokazana, a ne koliko je važna. Šta koja oznaka znači.
Crawling indexing ranking: koji nivo primene je opravdan?
Kriterijum se određuje prema funkciji dokumenta, vrsti tvrdnje i riziku pogrešne primene.
| MoraPotvrđena praksa | Svaki nalaz vezati za tačnu fazu i dokaz: robots.txt ili log za crawling, URL Inspection za indeksiranje i Performance podatke za prikaz. |
|---|---|
| TrebaPotvrđena praksa | Proveriti izvorni i renderovani HTML, canonical klaster i interne linkove pre nego što se problem nazove problemom rangiranja. |
| MožeUrednička preporuka | Koristiti kontrolisani test sa novim URL-om i server logovima kada je potrebno izmeriti brzinu otkrivanja i ponovnog crawlinga. |
| IzbegavatiUpozorenje | Zaključivanje da je dokument indeksiran iz `site:` operatora, da nije crawl-ovan zato što nema klikove ili da sitemap prisiljava indeksiranje. |
Crawling indexing ranking: primena korak po korak
Potvrdi URL
Zabeleži konačnu adresu, status, redirecte, robots.txt i izvor preko koga je URL otkriven.
Proveri obradu
Uporedi source i rendered HTML, glavni sadržaj, canonical, robots direktive i linkove koje crawler može da izdvoji.
Utvrdi indeksno stanje
U URL Inspection-u proveri poslednji crawl, dozvolu indeksiranja i odnos declared i selected canonical-a.
Analiziraj prikaz
U GSC-u filtriraj tačan URL, relevantne upite, zemlju, uređaj i period; uporedi prikaze pre klikova i pozicije.
Crawling indexing ranking: kako proveriti rezultat?
Najbrža dijagnoza ide redom, bez preskakanja faze. Ako crawler ne može da zahteva dokument, nema smisla prvo menjati naslov radi rangiranja. Ako je URL indeksiran, ali nema prikaze, tehnička dostupnost više nije dovoljna dijagnoza.
- URL je otkriven kroz crawlable HTML link ili naveden kao kanonski URL u sitemap-u.
- Crawler dobija očekivani status i nije blokiran pravilom koje sprečava potrebnu obradu.
- Renderovani HTML sadrži glavni tekst, H1, canonical i važne interne veze.
- Selected canonical odgovara nameravanom dokumentu ili je razlog odstupanja dokumentovan.
- Rangiranje se analizira kroz relevantan skup upita i segmenata, ne kroz jednu ručnu pretragu.
Crawling indexing ranking: šta ovaj standard ne dokazuje?
Google ne garantuje prolaz kroz sve tri faze čak ni kada stranica prati Search Essentials. Search Console daje podatke o Google Search-u, ali nije potpuni crawl log. Ručni rezultat može biti personalizovan ili lokalizovan, a prosečna pozicija predstavlja agregat zabeleženih prikaza, ne fiksnu poziciju URL-a.
Crawling indexing ranking: šta proveriti sledeće?
Povezani dokumenti rešavaju uži, zavisni ili sledeći korisnički zadatak u istom klasteru.
Crawling indexing ranking: na kojim izvorima se zasniva?
- Google: crawling, indexing i servingZvanična definicija tri faze i napomena da prolaz nije garantovan.
- Google: JavaScript SEO tokRedovi za crawling, renderovanje, obradu i izdvajanje linkova.
- Google: canonicalizacijaGrupisanje duplikata i izbor reprezentativnog URL-a tokom indeksiranja.
- Search Console metrikeDefinicije prikaza, klikova i pozicije za analizu serving faze.
Poslednja sadržajna provera: 26. avgust 2026.
Najčešća pitanja: Crawling indexing ranking
Može li crawl-ovana stranica ostati van indeksa?
Da. Crawling znači da je URL preuzet; indeksiranje je zaseban proces i Google može odlučiti da dokument ne čuva kao zaseban rezultat.
Može li indeksirana stranica imati nula klikova?
Da. Može imati malo ili nimalo prikaza, nisku vidljivost za posmatrane upite ili prikaze bez klika.
Da li sitemap ubrzava rangiranje?
Sitemap pomaže otkrivanju preferiranih URL-ova. Ne garantuje crawling, indeksiranje ni rangiranje.