Kako pretraživač pronalazi, obrađuje i prikazuje veb-stranice?
Jednostavno rečeno: Pretraživač radi u tri koraka: pronađe stranicu, obradi je i sačuva, pa je prikaže kada neko nešto traži. Ova oblast objašnjava svaki korak i šta na njega možete da utičete.Primer: Ako je nova stranica objavljena, ali nijedan link ne vodi do nje, Google je možda neće ni pronaći.
Pretraživač najpre otkriva URL, zatim preuzima i obrađuje dokument, procenjuje da li će ga čuvati u indeksu i tek pri konkretnom upitu bira rezultate koje smatra relevantnim i korisnim. Crawling (obilazak i preuzimanje stranica od strane pretraživača), indeksiranje i rangiranje zato nisu sinonimi niti uspeh u jednoj fazi garantuje prolaz u sledeću.
Šta Kako radi pretraga znači u praksi?
Životni ciklus dokumenta počinje kada crawler (Google-ov robot koji obilazi i preuzima stranice) pronađe URL preko linka, sitemap-a ili ranije poznate adrese. HTTP odgovor, robots pravila i dostupni resursi određuju šta sistem može da preuzme. Kod JavaScript stranice obrada može uključiti dodatni red za renderovanje pre nego što sadržaj i linkovi postanu dostupni sistemu.
Indeks nije prosta kopija interneta. Sistem bira reprezentativni URL, razume tekst, slike, jezik i odnose sa drugim dokumentima, pa može da odbije duplikat, vrlo slab dokument ili URL sa konfliktnim signalima. Kada korisnik pošalje upit, retrieval (izdvajanje dokumenata koji odgovaraju pitanju) pronalazi kandidate iz indeksa, a sistemi rangiranja određuju redosled prikaza. Zbog toga provera mora pratiti svaku fazu odvojeno.
Koliko dokumenta pretraživač uopšte preuzme?
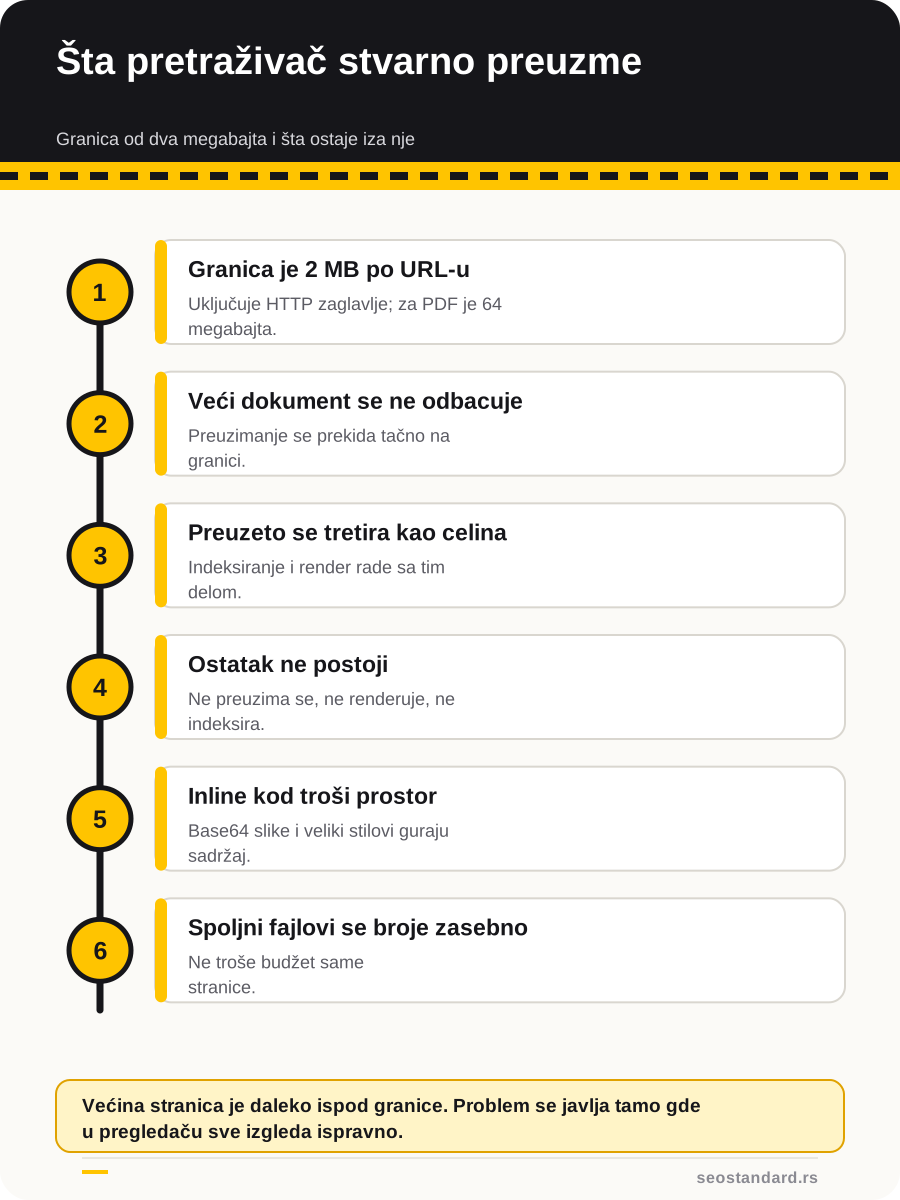
Pretpostavka da crawler preuzima ceo dokument je netačna, i Google je 2026. objavio konkretne brojeve. Googlebot preuzima najviše dva megabajta po URL-u, uključujući i HTTP zaglavlje. Za PDF datoteke granica je 64 megabajta.
Kada je dokument veći, ne odbacuje se. Preuzimanje se prekida tačno na granici, a preuzeti deo se dalje obrađuje kao da je ceo fajl. Sve iza granice ne postoji za sistem — ne preuzima se, ne renderuje (kada pretraživač izvrši kod stranice da vidi ono što vidi korisnik) i ne indeksira.
| Situacija | Posledica |
|---|---|
| Dokument ispod granice | obrađuje se u celini |
| Veliki inline CSS ili JavaScript na vrhu | gura sadržaj ka granici |
| Slike upisane kao base64 u HTML | isto, i najbrže troše prostor |
| Ogroman meni pre glavnog sadržaja | odgovor može ostati iza granice |
| Spoljni resursi u zasebnim fajlovima | imaju sopstveno brojanje, ne troše granicu stranice |
Poslednji red je i rešenje. Prebacivanje stilova i skripti u zasebne fajlove ne smanjuje samo vreme učitavanja — sklanja ih iz budžeta same stranice, jer se svaki referencirani resurs preuzima odvojeno i broji zasebno.
Većina dokumenata je daleko ispod granice i ovo ih se ne tiče. Tiče se stranica sa ugrađenim slikama, opsežnim inline kodom ili generisanim menijem od nekoliko hiljada stavki — a to su upravo stranice na kojima se problem najteže prepoznaje, jer u pregledaču izgledaju ispravno.
Granica od dva megabajta i šta ostaje iza nje
Kako radi pretraga: koje elemente treba razlikovati?
| Element | Značenje ili atribut | Dokaz ili funkcija |
|---|---|---|
| Otkrivanje | URL postoji u crawl putanji | Interni link, sitemap (spisak stranica koje sajt prijavljuje pretraživaču) ili poznati spoljašnji link |
| Crawling | Crawler može da zatraži dokument | robots.txt, HTTP status i server log |
| Obrada | Glavni sadržaj i linkovi mogu da se izdvoje | Izvorni i renderovani HTML |
| Indeksiranje | Sistem je izabrao dokument ili drugi canonical | URL Inspection i status indeksiranja |
| Prikaz | Dokument se bira za konkretan upit | GSC podaci po upitu, stranici, zemlji i uređaju |
Oznake uz kriterijume (Zahtev, Potvrđena praksa, Urednička preporuka, Upozorenje, Hipoteza) pokazuju koliko je tvrdnja dokazana, a ne koliko je važna. Šta koja oznaka znači.
Kako radi pretraga: koji nivo primene je opravdan?
Kriterijum se određuje prema funkciji dokumenta, vrsti tvrdnje i riziku pogrešne primene.
| MoraPotvrđena praksa | Za svaku dijagnozu prvo odrediti fazu u kojoj nastaje problem: zahtev, obrada, izbor canonical-a, indeksiranje ili prikaz. |
|---|---|
| TrebaPotvrđena praksa | Porediti izvorni HTML, renderovani HTML, server odgovor i podatke Search Console-a; jedan alat ne opisuje ceo životni ciklus. |
| MožeUrednička preporuka | Koristiti server logove i kontrolisano testiranje kada je potrebno razlikovati otkrivanje URL-a od stvarnog poseta crawlera. |
| IzbegavatiUpozorenje | Zaključak da je URL indeksiran zato što vraća 200, nalazi se u sitemap-u ili prolazi live test. |
Kako radi pretraga: primena korak po korak
Proveri zahtev
Potvrdi konačni URL, status kod, redirect lanac i da li robots.txt dopušta zahtev relevantnom crawleru.
Uporedi HTML
Proveri da li su naslov, glavni sadržaj, canonical i interni linkovi prisutni u izvornom i renderovanom dokumentu.
Utvrdi izbor
U URL Inspection-u razdvoji user-declared canonical od canonical-a koji je izabrao Google i zabeleži razlog odstupanja.
Meri prikaz
U Performance izveštaju segmentiraj upite, stranice, zemlju, uređaj i period; ne zaključuj iz prosečne pozicije celog sajta.
Kako radi pretraga: kako proveriti rezultat?
Dijagnoza je potpuna tek kada nalaz imenuje fazu, dokaz i sledeći test. Izraz „Google ne vidi stranicu” nije dovoljan bez razlike između crawlinga, renderovanja, indeksiranja i prikaza.
- Konačni URL vraća očekivani HTTP status bez nepotrebnog redirect lanca.
- robots.txt ne blokira resurse potrebne za razumevanje glavnog sadržaja.
- Canonical, interni linkovi i sitemap upućuju na istu indeksabilnu varijantu.
- Glavni tekst i ključni linkovi postoje u renderovanom HTML-u na mobilnom prikazu.
- GSC nalaz je segmentiran i vezan za tačan URL, period i tip pretrage.
Kako radi pretraga: šta ovaj standard ne dokazuje?
Ni tehnička dostupnost ni uspešan live test ne obavezuju Google da indeksira URL. Search Essentials izričito navodi da ispunjavanje zahteva i najboljih praksi nije garancija crawlinga, indeksiranja ili prikaza. Podaci Search Console-a takođe nisu server log: oni opisuju Google Search obradu i performanse, ne svaki zahtev crawlera.
Koje stranice pripadaju ovom klasteru?
Svaki URL rešava zaseban micro-intent i vraća korisnika na ovaj hub.
Crawling indexing ranking
Koja je razlika između crawlinga, indeksiranja i rangiranja?
Otvori standard →P0Search intent
Šta je search intent i kako određuje funkciju stranice?
Otvori standard →P1Canonicalizacija
Kako pretraživač bira reprezentativni URL?
Otvori standard →P1Neuralno podudaranje
Kako se koncepti u upitu povezuju sa sadržajem bez istih reči?
Otvori standard →P1Ranking sistemi
Šta rade sistemi rangiranja, a šta SEO ne može garantovati?
Otvori standard →P1Retrieval
Kako sistem bira dokumente relevantne za upit?
Otvori standard →P2Personalizacija i kontekst
Kako lokacija, jezik, uređaj i kontekst menjaju rezultate?
Otvori standard →P2Query fan out
Kako složen upit može biti razložen na više podržavajućih pretraga?
Otvori standard →Kako radi pretraga: šta proveriti sledeće?
Povezani dokumenti rešavaju uži, zavisni ili sledeći korisnički zadatak u istom klasteru.
Kako radi pretraga: na kojim izvorima se zasniva?
- Google: kako Search radiZvanični pregled crawlinga, indeksiranja i prikaza rezultata.
- Google: osnove JavaScript SEO-aTok crawlinga, renderovanja, obrade i status kodova.
- Google Search EssentialsMinimalni tehnički zahtevi, spam politike i ključne najbolje prakse.
Poslednja sadržajna provera: 25. avgust 2026.
Najčešća pitanja: Kako radi pretraga
Da li URL u sitemap-u mora biti indeksiran?
Ne. Sitemap je signal za otkrivanje i prioritetno obaveštavanje, ali ne garantuje crawling ni indeksiranje.
Da li status 200 znači da je stranica indeksabilna?
Ne samostalno. Potrebni su dostupnost crawleru, odgovarajuće robots direktive, sadržaj koji se može obraditi i nekonfliktni canonical signali.
Kada proveravati server logove?
Kada treba potvrditi da li je crawler stvarno zahtevao URL ili resurs. Search Console ne zamenjuje potpun server log.